
Блог · страница 2
Разборы для тех, кто арендует GPU: выбор карты, запуск нейросетей, цены и экономия.
Как сэкономить на аренде GPU: без оплаты простоя, с чекпоинтами и поминутной оплатой
Забытый на ночь сервер с A100 съедает 12 часов оплаты. Как сэкономить на аренде GPU: поминутная оплата, сигнал о простое, чекпоинты и лимит баланса.
Как выбрать сервер с GPU: VRAM, CPU, диск и сеть — чек-лист
Чек-лист из 10 пунктов: сколько видеопамяти, ядер CPU, ОЗУ и NVMe нужно серверу с GPU, какая сеть не держит карту в простое и как проверить машину за 5 минут.
Облачный сервер с GPU или своя видеокарта: что выгоднее за год
Своя RTX 4090 обходится примерно в 5 000 ₽ в месяц ещё до первого запуска. Считаем, при скольких часах работы в месяц покупка выгоднее аренды.
Open WebUI и Ollama: свой ChatGPT в браузере на арендованной видеокарте
Свой ChatGPT на арендованной GPU за 20 минут: Ollama, Open WebUI и SSH-туннель. Какую карту взять под Qwen3, gpt-oss и Llama 70B и сколько стоит час.
Первый запуск на арендованной GPU: SSH, Jupyter и данные за 15 минут
Как подключиться к арендованной GPU за 15 минут: SSH-ключ, Jupyter в браузере, загрузка данных через scp и Hugging Face, проверка карты и остановка без лишних трат.
Qwen, DeepSeek или Llama: какая открытая LLM лучше понимает русский в 2026
Qwen заявляет 201 язык, в официальном списке Llama 4 русского нет, DeepSeek V4 сильна в рассуждениях. Сравниваем модели, память и цену запуска.
RTX 4090 для нейросетей в 2026: что тянут 24 ГБ и где они упираются
RTX 4090 для нейросетей: LLM до 32B в 4 битах, Flux в FP8, LoRA и QLoRA до 14B. Где 24 ГБ хватает, где нет и что брать вместо — с ценами за час.
RTX PRO 6000 на 96 ГБ: замена H100 для инференса больших моделей?
RTX PRO 6000 даёт 96 ГБ против 80 ГБ у H100, но память у неё в 1,9 раза медленнее. Разбираем, какие LLM на ней выгоднее держать и где H100 всё же нужна.
Selectel или GPU-маркетплейс: где дешевле час H100 и RTX 4090 в 2026
RTX 4090 в облаке Selectel — около 105 ₽ за карту в час, выделенный сервер — 56 900 ₽ в месяц. Сравниваем с маркетплейсами по цене, оплате и документам.
Сервер с H100: 1, 4 или 8 карт — что брать под обучение и инференс
Сервер с H100 на 1, 4 или 8 карт: 80, 320 или 640 ГБ памяти, какие модели влезают, SXM или PCIe и сколько стоит час — 277–329 ₽ за одну карту.
Сервер с видеокартой для игр: можно ли играть на арендованной GPU
Играть на арендованной GPU можно тремя способами: облачный гейминг от 24 ₽/час, Windows-сервер с Moonlight или Parsec, своя игровая сборка. Плюсы и подводные камни.
Serverless GPU или аренда сервера: когда выгоднее платить за запрос
Serverless GPU выгоден при редких запросах, аренда — при нагрузке от 4–6 часов в сутки. Считаем точку безубыточности на ценах RunPod и Modal.
Сколько GPU нужно на 1000 пользователей чат-бота: расчёт нагрузки и цены
Чат-боту на 1000 активных пользователей в день с моделью 8B хватает одной RTX 4090, для 70B нужно 2 карты по 80 ГБ. Формулы, KV-кеш и цена в месяц.
Сколько стоит держать LLM 70B онлайн: час, сутки и месяц в рублях
Модель 70B в 4 битах занимает около 42 ГБ: считаем час, сутки и месяц работы на A6000, 2× RTX 4090, A100 и H100 и цену миллиона токенов.
Удалённый компьютер с видеокартой: аренда ПК, VPS с GPU или GPU-сервер
Три способа арендовать удалённый компьютер с видеокартой: облачный ПК с Windows, VPS с долей GPU и Linux-сервер с целой картой. Чем отличаются, кому что и сколько стоит.
Видеокарта для машинного обучения: купить или арендовать — расчёт
Б/у RTX 3090 за 55–75 тыс. ₽ окупается с 50–85 часов обучения в месяц. Когда покупать, а когда арендовать: расчёт для студента, ML-инженера и стартапа.
Yandex Cloud с GPU или маркетплейс: что выбрать ML-команде в 2026
Yandex Cloud GPU: A100 от ~472 ₽/час за минимальную ВМ с НДС по данным на 14.10.2026. Сравниваем с маркетплейсом по цене, квотам, документам и надёжности.
Нейросеть для рекламных креативов: кейс агентства с 500 баннерами в неделю
Как маркетинговое агентство генерирует визуалы для таргета и A/B-тестов на арендованной видеокарте: бренд-стиль, пакетная генерация, тексты, время и бюджет в рублях.
Нейросеть для 3D-моделей и текстур игры: кейс инди-студии на RTX 4090
Как инди-студия из трёх человек генерирует бесшовные текстуры и черновые 3D-модели для игры на арендованной видеокарте: инструменты, пайплайн, время и цены.
Как обучить нейросеть своему стилю за вечер: кейс иллюстратора с LoRA на Flux
Как иллюстратор без видеокарты обучает LoRA на своих работах и делает серию из 300 картинок на арендованной RTX 4090. Шаги, время, стоимость в рублях.
Нейросеть для фото товаров для маркетплейса: 200 карточек без фотостудии
Как продавец на Wildberries и Ozon делает фон, свет и инфографику для карточек на арендованной видеокарте. Пошагово, со временем и стоимостью в рублях.
Нейросеть для разделения трека на дорожки: кейс музыканта — стемы, ноты, демо
Как музыкант и преподаватель гитары разделяет записи на стемы, переводит партии в ноты и делает аранжировки-черновики на арендованной видеокарте. Инструменты и цены.
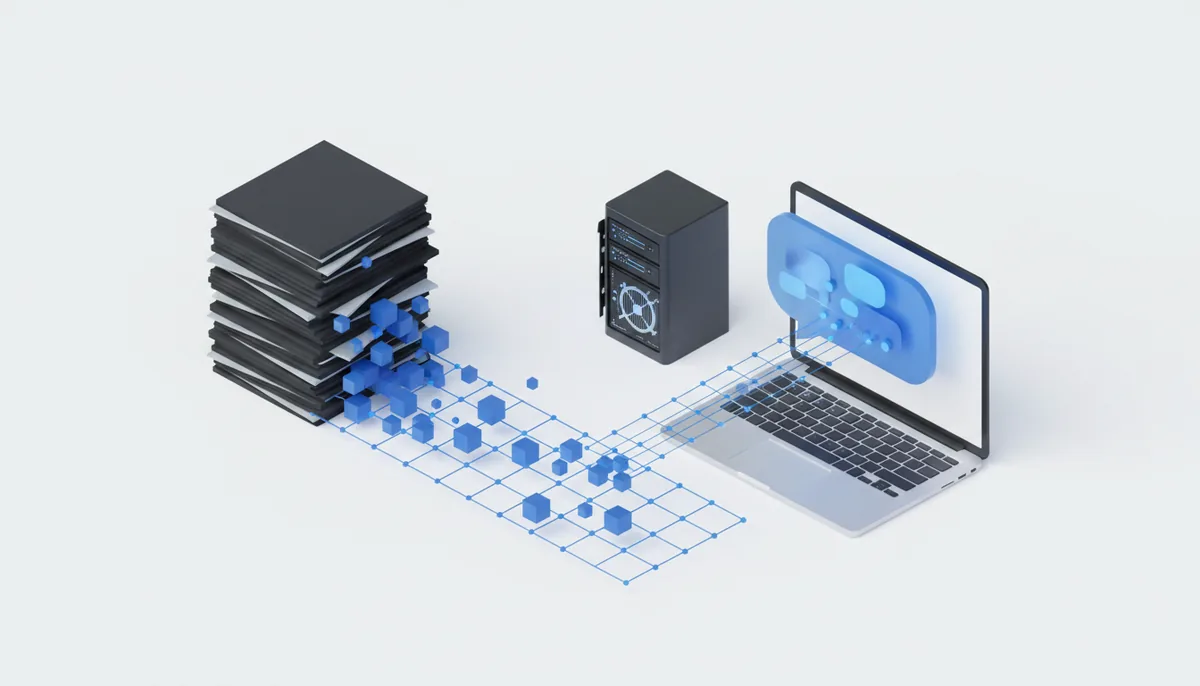
ИИ-ассистент по документам компании на своей LLM: кейс стартапа
Как команда из трёх разработчиков подняла Qwen с поиском по 5000 документов на арендованной видеокарте: архитектура, выбор GPU, сроки и бюджет пилота в рублях.
Видеокарта для диплома по машинному обучению: кейс магистранта на RTX 3090
Как магистрант обучил модель поиска дефектов на фото для диплома на арендованной RTX 3090: эксперименты, время, бюджет в рублях и ошибки, которых стоит избежать.
Нейросеть для субтитров к видео и апскейла: кейс видеоблогера с 300 роликами
Как автор YouTube- и VK-канала расшифровывает 40 часов видео, переводит субтитры и улучшает старые записи на арендованной видеокарте. Инструменты, время и цены.
Нейросеть для проверки договоров: кейс юристов с открытой LLM и чек-листом рисков
Как юридическая компания ускорила проверку договоров поставки открытой LLM на арендованной видеокарте: обезличивание, чек-лист рисков, время и бюджет в рублях.
Аренда GPU для стартапа: как не переплатить на MVP и пилоте
Сколько стоит GPU для MVP и пилота ИИ-стартапа: бюджеты от 2 244 ₽ в месяц, выбор карты по этапу, поминутная оплата и 8 способов сократить счёт.
Аренда H100 в 2026: сколько стоит час и месяц работы
Аренда H100 80 ГБ — 277–329 ₽/час с поминутной оплатой: считаем стоимость дня, месяца и типовых задач, разбираем, от чего зависит цена GPU.
GPU-маркетплейс или облако: что выбрать для ИИ-задач
Сравниваем GPU-маркетплейс и классическое облако по цене, выбору карт, надёжности и запуску. Когда что выгоднее и как сочетать, с ценами от 13 ₽/час.
Скорость генерации токенов LLM: от чего зависит и как оценить
Почему скорость LLM упирается в пропускную способность памяти, как по одной формуле оценить токены в секунду для своей модели и выбрать GPU от 13 ₽/час.
Как выбрать GPU для Stable Diffusion и Flux по задачам
Портреты, обучение LoRA, видео, пакетная генерация: какая видеокарта нужна под каждый сценарий Stable Diffusion и Flux и сколько стоит час — от 13 ₽.
Как запустить DeepSeek R1 на арендованной GPU: инструкция
Запускаем DeepSeek R1 и дистилляты 7B–70B через Ollama и vLLM: сколько памяти нужно, какая GPU подойдёт и сколько стоит час — от 34 ₽.
Обучение на нескольких GPU: DDP, FSDP и выбор 2, 4 или 8 карт
Когда нужно обучение на нескольких GPU, чем DDP отличается от FSDP и DeepSpeed и как выбрать конфигурацию из 2, 4 или 8 карт. Расчёт памяти и цены.
Рейтинг видеокарт для обучения нейросетей 2026: таблица
Сравнили 14 видеокарт для обучения нейросетей по памяти, скорости и цене часа: от RTX 3060 за 13 ₽ до B200 за 1543 ₽. Какая карта выгоднее под задачу.
Российские LLM локально: T-Pro, Vikhr, GigaChat, YandexGPT
Какие российские LLM с открытыми весами можно запустить у себя: T-Pro, T-Lite, Vikhr, GigaChat, YandexGPT Lite. Сколько памяти нужно и какая GPU от 13 ₽/час.
Whisper на GPU: скорость и цена расшифровки часа аудио
Расшифровка аудио Whisper на арендованной GPU: час записи за несколько минут и несколько рублей. Какая карта нужна, как ускорить faster-whisper и что с русским языком.
Аренда GPU для рендеринга в Blender: быстрее и дешевле
Аренда GPU для рендеринга в Blender от 34 ₽/час: Cycles с OptiX на RTX 3090, 4090 и 5090, рендер из командной строки, расчёт стоимости анимации.
Как оплатить аренду GPU из России в 2026: карта РФ, криптовалюта, посредники
Как платить за аренду GPU из России: 4 способа с комиссиями и рисками. В Тераферме баланс в рублях, пополнение картой российского банка или USDT и BTC от 500 ₽.
Как выбрать сервер с видеокартой для ИИ: VRAM, CPU, диск
Как выбрать сервер с GPU для нейросетей: сколько видеопамяти, ОЗУ, ядер CPU и диска нужно под LLM, генерацию и обучение. Чек-лист из 7 пунктов и таблица конфигураций.
Какую видеокарту выбрать для нейросети: под задачу и бюджет
Какую видеокарту выбрать для нейросети: сколько памяти нужно под Stable Diffusion, Flux, LLM и LoRA, что брать из RTX 3090, 4090, 5090 и A100. Таблицы и цены.
Что такое аренда GPU и как это работает: простое объяснение с ценами
Аренда GPU — доступ к видеокарте через интернет с оплатой по минутам. RTX 4090 от 54 ₽/час, без покупки железа. Как устроено и сколько стоит.
ComfyUI на арендованной GPU: установка, модели и доступ из браузера
Ставим ComfyUI на арендованную видеокарту за 15 минут: RTX 4090 за 54 ₽/час, SDXL и Flux, загрузка моделей, SSH-туннель и экономия минут.
Дообучение LoRA и QLoRA на арендованной GPU: память, время и цена
QLoRA модели 8B на RTX 4090 обходится в 162–270 ₽. Сколько памяти нужно под LoRA для 7B–70B, какую GPU арендовать и как запустить обучение.
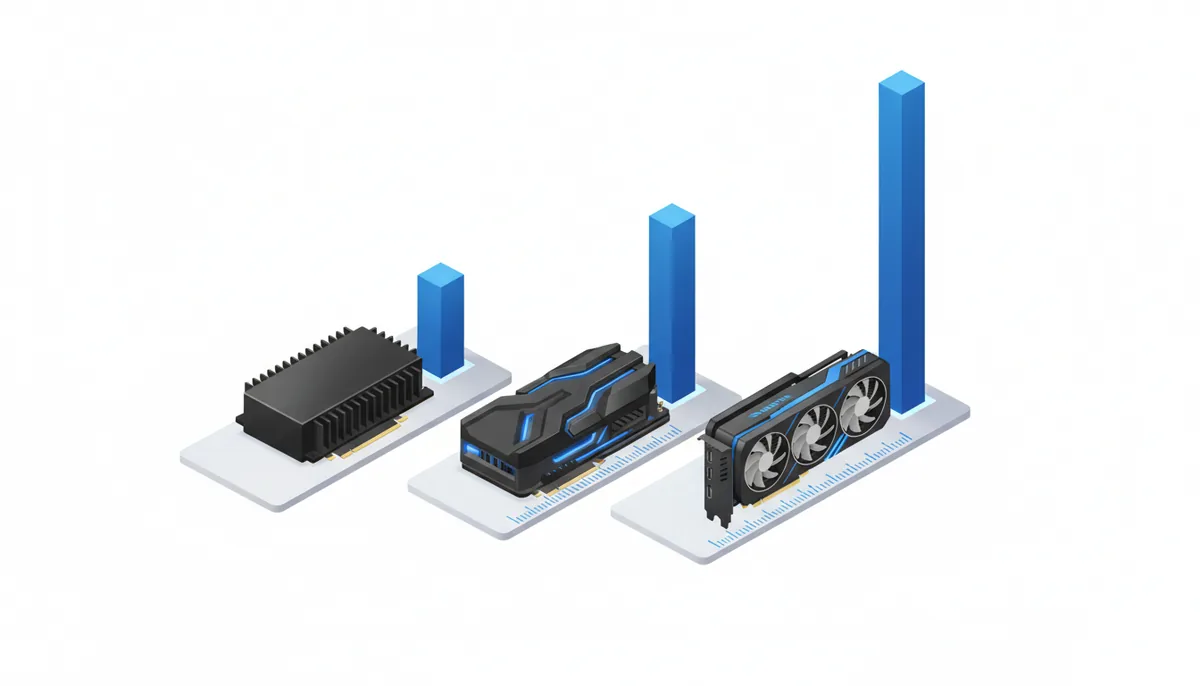
H100 vs A100 vs RTX 4090: что выбрать для нейросетей
Сравниваем H100, A100 и RTX 4090 по памяти, скорости и цене часа: 277–329, 154 и 54 ₽. Что выгоднее для обучения LLM, инференса и генерации.
Как запустить Llama на арендованной GPU: vLLM и Ollama по шагам
Запускаем Llama 8B и 70B на арендованной видеокарте за 15 минут: команды для Ollama и vLLM, выбор GPU от 34 ₽/час, OpenAI-совместимый API.
Облачные GPU в России в 2026: как выбрать сервис и на что смотреть
Облачные GPU в России в 2026: три типа сервисов, 8 критериев выбора, цены от 13 ₽/час за RTX 3060 до 277–329 ₽/час за H100, поминутная оплата в рублях.
Почасовая аренда GPU или выделенный сервер: расчёт, что выгоднее
Считаем точку безубыточности: при загрузке ниже 60–80% почасовая аренда GPU дешевле выделенного сервера. Формулы, таблицы и примеры на RTX 4090 и A100.
RTX 5090 для ИИ: стоит ли арендовать вместо 4090
RTX 5090 для ИИ: 32 ГБ GDDR7 и 1,8 ТБ/с за 67 ₽/час. Где она обгоняет RTX 4090 и A100, когда аренда выгоднее покупки — расчёты.
Сколько стоит обучить нейросеть: считаем GPU-часы и цену в рублях
Стоимость обучения = GPU-часы × цена часа. BERT — от 17 ₽, QLoRA 8B — около 216 ₽, модель 1B с нуля — 23 268–27 636 ₽. Формулы и примеры.
Сколько видеопамяти нужно для LLM: таблица 7B–70B
Сколько видеопамяти нужно для LLM: модели 8B в 4 битах хватает 6 ГБ, 70B — около 42 ГБ. Формула расчёта, KV-кэш, обучение и подбор карты.